티스토리 뷰
https://www.youtube.com/watch?v=7QfEpRTRdIQ&list=PL3Re5Ri5rZmkY46j6WcJXQYRlDRZSUQ1j&index=2
1. 카프카 이전...
데이터를 받는 타겟 애플리케이션
데이터를 전송하는 소스 애플리케이션
단방향 통신
--> 타겟과 소스가 많아질수록 데이터를 전송하는 라인이 많아졌다
--> 데이터를 전송하는 라인이 많아지면 관리, 배포가 힘들어진다
--> 더해서 데이터를 전송하는 프로토콜들이 다 다르니까 더 복잡하고 힘들며 파편화? 가 심해짐
2. 카프카 이후
링크드인에서 개발
오픈소스
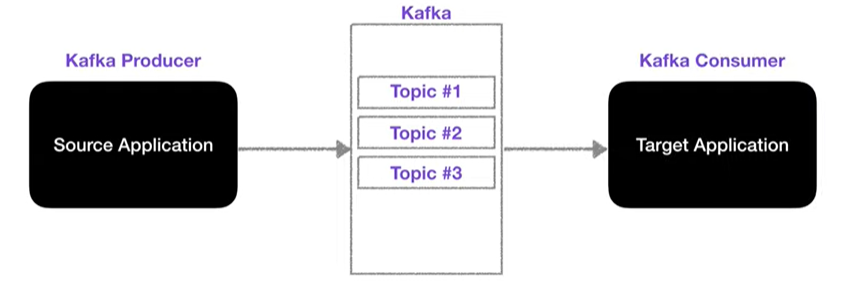
소스 애플리케이션과 타겟 애플리케이션의 커플링을 약하게 하기위해 나왔다.
소스 애플리케이션은 카프카에 데이터를 보내고
타겟 애플리케이션은 카프카에서 데이터를 가져온다.
여기서 카프카는 데이터를 전송할 데이터를 담는 큐 역할을 한다고 볼 수 있다.
카프카 내부에는 "토픽" 이라는 것이 있고
이 토픽에 데이터가 들어가게된다.
카프카에서 소스 애플리케이션 즉, 데이터를 주는 애플리케이션은 "프로듀서" 라고 부르고
타겟 애플리케이션, 데이터를 받는 애플리케이션을 "컨슈머" 라고 부른다.
3. 카프카 토픽
- 토픽은 DB의 테이블이나 파일시스템의 폴더와 유사한 성질을 지님
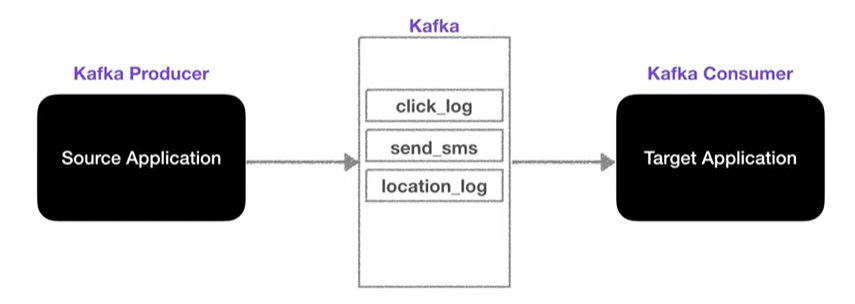
- 카프카의 토픽은 이름을 가질 수 있다.
- 해당 토픽이 무슨 데이터를 담는지 명확하게 명시하면 추후 유지보수시 편리하게 관리할 수 있다.
- 하나의 토픽은 여러개의 파티션으로 구성될수 있으며, 첫번째 파티션의 번호는 0번이다.
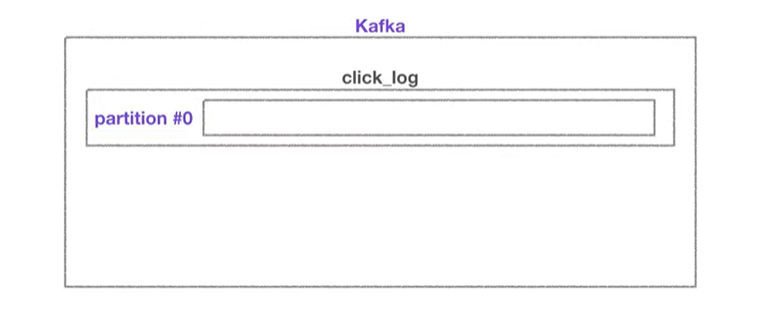
- 프로듀서가 데이터를 보내면 데이터는 파티션 내부에 쌓이게되고
- 컨슈머는 가장 오래된 데이터부터 가져가게된다. (선입선출)
- 데이터를 요청했을 때 데이터가 없으면 컨슈머는 새로운 데이터가 들어올때까지 기다린다.
- 컨슈머가 파티션에서 데이터를 가져가더라도 데이터는 삭제되지 않고 남아있다
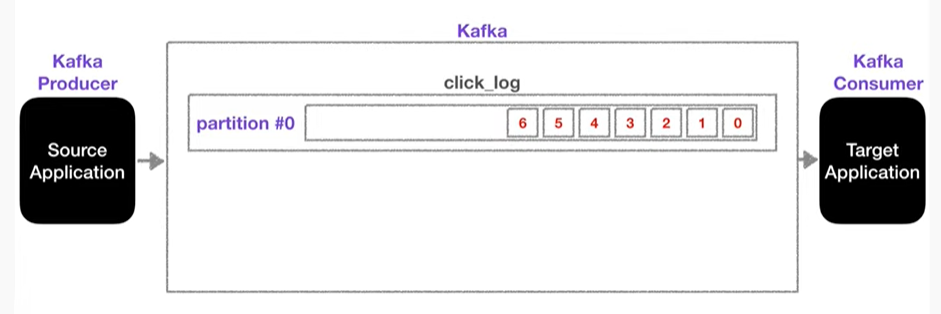
파티션에 남은 데이터는 어떻게 되는가?
- 새로운 컨슈머가 붙었을때 다시 0번부터 가져가서 사용할 수 있다
- 단, 컨슈머 그룹이 달라야하고 & auto.offset.rest=earliest 여야한다.
- 이처럼 사용할 경우, 동일 데이터를 두번 사용할 수 있게 되는데 이는 카프카를 사용하는 아주 중요한 이유다.
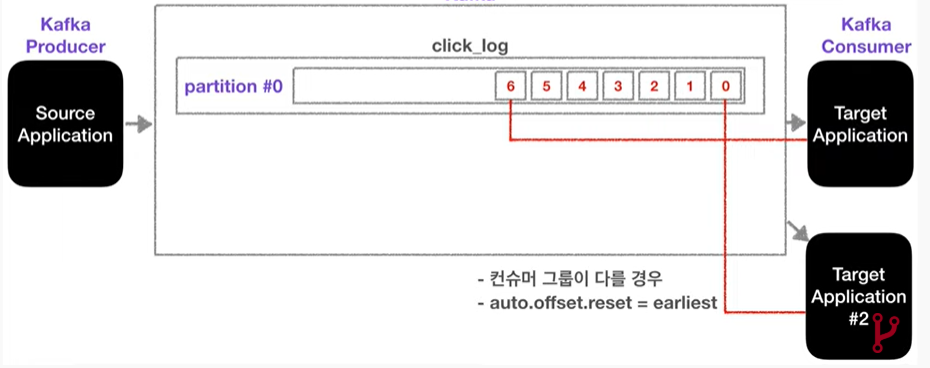
- 클릭 로그를 분석하기위해 엘라스틱 서치에 데이터를 저장하기도하고
- 클릭 로그 백업을 위해 하둡에 저장하기도 한다
- 즉, 카프카의 컨슈머는 엘라스틱 서치, 하둡등이 오게되는 것.

토픽의 파티션이 여러개인 경우는?
- 프로듀서로부터 클릭 로그 데이터가 들어왔다. 어느 파티션으로 들어가야 할까?
- 데이터를 보낼때 "key"를 지정해서 보낼 수 있다
* key = null, 기본 파티셔너를 사용하는 경우
-> 라운드로빈 방식으로 파티션이 지정된다.
* key != null, 기본 파티셔너를 사용하는 경우
-> 키의 해시값을 구하고 특정 파티션에 할당한다.
- 파티션을 늘리는 것은 매우 조심해야한다
- 파티션을 늘리는 것은 가능하지만 다시 줄일 수 는 없기 때문!!
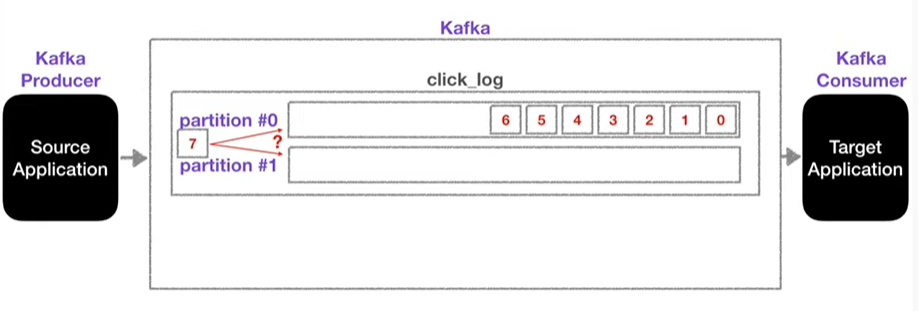
왜 파티션을 늘리는 것일까?
-> 파티션을 늘리면 컨슈머의 개수를 늘려서 데이터 처리를 분산시킬 수 있다.
파티션의 데이터는 언제 삭제될까?
-> 삭제되는 타이밍은 옵션에 따르다
-> 레코드가 저장되는 최대시간과 크기를 지정할 수 있다. (** 레코드 = 파티션에 들어가는 데이터)
* log.retention.ms : 최대 record 보존 시간
* log.retention.byte : 최대 record 보존 크기
'데이터 엔지니어 > 그외' 카테고리의 다른 글
| [카프카] #6 Lag (2) | 2020.06.16 |
|---|---|
| [카프카] #5 카프카 왜 좋은가?? (0) | 2020.06.16 |
| [카프카] #4 카프카 Consumer (0) | 2020.06.16 |
| [카프카] #3 Broker, Replication, ISR (1) | 2020.06.16 |
| [카프카] #2 카프카 Producer (1) | 2020.06.16 |